如何看待论文AIGC检测率以及正确的AIGC在论文中的使用方法
森克兰特降AI率全能网站:https://paper.ai-or.com,公告里面有最多24888免费字符领取方法!下面是博主微信公众号。
现在很多学校除了查知网重复率之外,AIGC检测率结果也会被纳入论文审核当中。很多同学对于查重、AIGC检测的区别不是很清楚。
查重就是把你的文字与已经存在的文献库进行比较,从而确定是否存在抄袭行为。但是这与AIGC检测率,在逻辑上完全不同。AIGC率检测不会去数据库搜索你写的文章内容,而是根据文本的语言特征进行概率上的推测,从而判断出行文风格是更偏向于人工还是大模型生成。因此,该定性判决并不是非黑即白的,有可能出现错误判断的情况。这也是大家抱怨的原因。
根据我手中修改过的大量的稿件来看,很多同学为了省事,就用AI二次修改、批量同义词替换、来回机器翻译,用一些免费平台或者学生版账号在检测平台上看到数值下降了,换成教师版检测工具后,直接大片标红,AIGC检测率不达标。
还有一些人为了得到比较低的AIGC检测结果,强行修改论文中专业的表述,修改完毕之后AIGC率确实能通过,但是逻辑混乱,就连自己都读不通,怎么能保证教师睁一只眼闭一只眼?
今天我把自己实际操作验证过的那一套方法分享给大家,区分出哪些是临时治标的方法,哪些才是真正的治本方法。
主流AIGC检测工具主要针对以下四种类型的文本进行检测
第一点就是句子的长度非常一致。人工智能生成的文字,句子大都只有15-25 个字,缺少普通人写作时长短交错的节奏感,并且喜欢堆砌工整排比句、成套的过渡词等。相关的平台后台数据也表明,句式高度同质化的文本更容易触发AIGC被检测率。
第二点就是用词模板化。大模型会频繁地使用同一种修饰、过渡词,输出的文字永远是四平八稳,并没有写出作者自己的思考倾向。
第三点就是逻辑过渡太顺畅了。写论文的人难免会提出问题、补充限制条件,也会坦然地写出研究中出现的矛盾和不确定因素。但是人工智能却很少留下这样的痕迹,整篇文章面面俱到,读起来缺少思辨性。这也是我在比较了上百份学生的稿件之后所感受到的一个最大的不同点。
第四点就是内容空洞,没有专属的细节。大模型好输出通用套话,但是你的手头问卷数据、实验中遇到的意外误差、实地调研观察到的情况,这些都是独一无二属于你课题的细节,人工智能是无法凭空创造出来的。
还有一个很重要的误区是:检出率高,并不能说明这篇就是由人工智能生成的。有的同学全文都是自己写的,但是行文过于规范,也会被检测工具误判。反过来,当人工智能生成的第一稿经过深度重构之后,如何有大量的自己研究的素材,检测到的风险也会大大降低。
因此,我们在平时学习或者课题中,就需要养成记录的好习惯,比如用workbuddy或者Obsidian结合AI工具搭建自己的知识库。有了自己的核心内容,AIGC检测率至少低30%以上,而且文章的质量更高。
除此之外,要减少AIGC检测率的话,我会把它分三类来处理。
首先对基本部分进行改写,适用于轻度超标的情况。单纯的同义词替换基本上就是无效修改了,换平台就失效了,这一点我亲身经历了很多次。
第一个小技巧就是故意改变句子的长度。AI喜欢的是全部都是中等长度的陈述句。长句后面接短句,复杂的句子拆分成简单的句子,零散的短句可以适当合并,以制造出自然的节奏起伏。
举个例子。AI写作的内容是:数字化转型可以降低中小企业的运营成本、提高内部管理水平、增强企业的市场竞争力。我改写为长短句结合:数字化转型对于中小企业的好处主要表现在降低运营成本这一方面。但是我们不能把它的功效夸大到不可置信的程度。能否把管理效率真正提上去,就看配套的组织制度是否跟上了,最后才能转化为实实在在的竞争优势。
第二,经常变换句子开头的方式。不要每句话都从主语开始,可以使用条件、背景、文献引用等方式来开启一段文字,主动和被动两种句式也可以适当穿插使用,打破模板化的感觉。
第三,尽量少用成套的连接词。“首先、其次、综上所述”“不是...而是...”这样的词语是人工智能高频次输出的内容,并不是必须强加进去的内容,在段落之间靠内容自然衔接的时候,部分观点可以用设问的形式来表达。我们直接在提示词里面加上限制。
但是句式的调整只能解决表达方面的问题。要使检测平台的检出分数趋于稳定并降低,关键在于往文本中添加只有你自己的研究成果所特有的信息,这是大模型无法复制的。
在论述的过程中可以插入一手的研究细节:原始数据的特殊表现、做实验遇到的各种误差、问卷中典型样本案例、线下调研所见真实情况。这些独一无二的细节,可以直接提高文本的人工属性。
森克兰特建议大家在文章中多做一些辨析工作,比如把各个学者之间的分歧点列出来,并指出前人的研究存在哪些不足之处,然后解释自己得出的结果为什么不同于其他人的结论。复述观点是人工智能擅长的事情,但是辨别、权衡、提出自己的看法,则是人所从事的工作,也是我在日常修改中经常用到的方法。
另外,在研究中要敢于面对自己的不足之处。AI 很喜欢给出没有漏洞的结论。可以主动写出结论适用的范围和边界,指出样本、变量所带来的一些限制,并且写下之后还可以继续深入探究的方向。带有保留意味的表达方式也会使 AI生成的痕迹明显减弱。
相比于写完之后的修改,更加理想的做法是,在写作之初就尽量避免 AI 的痕迹,而这也是我个人所推崇的工作方式。
不要一次把所有的指令都丢给人工智能去生成完整的章节。把整个大段落拆分成几百字的小片段,把AI看作是思路启发、文献整理的工具,拿到内容之后马上手动重新构建。
首先自己动手写出大纲,把主要论点和数据结论先确定下来,然后再让人工智能帮忙补充素材,在整个过程中自己牢牢掌握着逻辑主线,而不能被人工智能所牵制。
更有效的办法就是读出AI输出的内容之后,再用自己对内容的理解重新写一遍。这样就可以完全脱离原来语序和句式的束缚,改写的效果远远大于逐字修改。当然这样比较费时间,其实也很好,通过森克兰特的验证,一篇3万字的文章,1-2 天就能手工复写完。
今天是2026年10月,去年同学们使用的中译英再翻译回中文的翻译方法,已经不好使了。容易把专业的术语歪曲,逻辑断裂,目前主流的检测平台对于翻译改写文本的识别能力也在提高。
还有一些人为了躲避检查,故意写出错别字或者制造出病句来。把论文交给导师和盲审专家看,第一眼就会发现其中的问题,得不偿失。
我们也不用执着于AIGC检出率为 0%。AIGC 检测本身就有假阳性的风险。我见过很多同学为了达到0%的目标,把本来很规范、严谨的论文修改得面目全非。只要达到学校规定的合格标准,保留你的核心思想就可以,并不需要追求极致的数据。
AIGC处理工具只能作为辅助工具使用。论文的主要观点、数据处理、完整的论述建议是你自己独立完成的,可以按照AI给你的分析方法进行实验或者课题的研究。
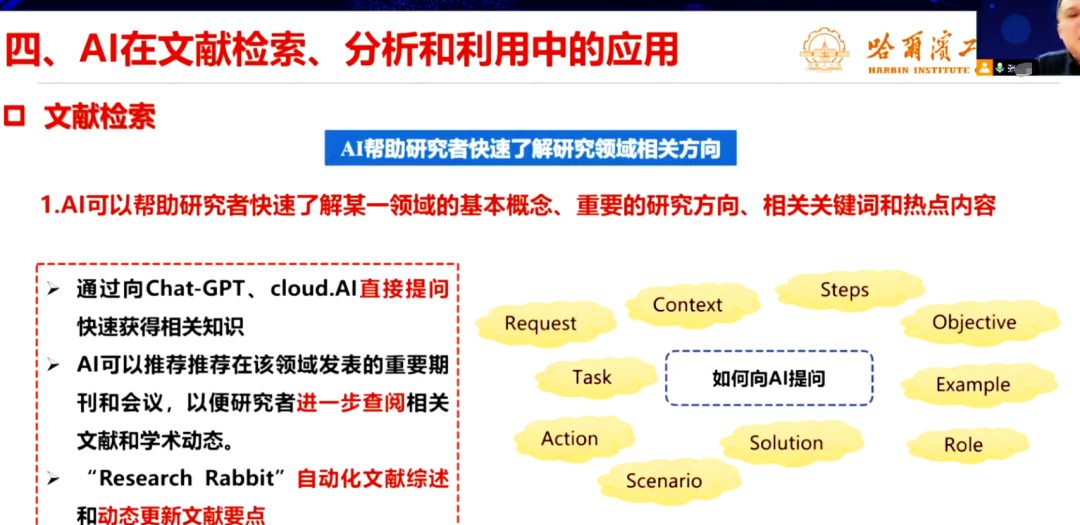
森克兰特结合一些实际操作层面的检测校正,给大家一些小建议。
1、不同的检测器算法有不同的标准,仅仅依靠一个平台的结果是不够的。在定稿之前,最好准备两套以上的工具进行交叉比较。比如很多免费的AIGC率检测平台,都存在虚高的情况,应该以权威一点的检测平台为准,如果有教师版的账号,检测率是更准确的。
2、不需要全文大动干戈,先解决被标红的高检出部分。摘要、文献综述、理论基础等都属于高危区域,需要重点核对。我自己修改稿件的时候会用一种很笨的方法,朗读全文。机器生成的文字读起来过于顺滑刻板,人工修改之后的内容会有一些自然的停顿和条件限制,读起来更加接近普通人的话语习惯。
3、很多同学AIGC检测率高的核心原因就是全文AI,我估计是用一句话提示词写出来的。我的建议就是就算你用提示词,也要用一些差异化的提示词,提示词的字数不能低于500字,并且要结合你自己的研究素材进行写作。
4、人工智能擅长的是产生面面俱到、无懈可击的文字。但是你的毕业论文就是你自己做的研究,里面包含了你整理好的调研资料,还有你在阅读了文献之后所形成的一些个人看法,但是也需要接受到研究本身存在的一些不足和选择。
森克兰特认为,人工智能可以帮我们打开思路、理清框架,但是核心论证、一手证据、思辨的过程,则需要我们自己去打磨。做到这一点,并不只为了避免被AIGC检测到,这也是做毕业论文的意义所在。
发表评论 取消回复